Практические разборы, которые можно проверить в своей работе.
🗓 окно 12–19 октября 2026⚡ статей: 9👀 на заметку: 3📡 отсканировано: 335
📝 О чём пишут на этой неделе
В этой подборке чаще всего встречаются две инженерные задачи: как дать агенту нужный контекст и как проверить его результат. Авторы измеряют Rerank и MCP-инструменты, строят память проекта и ограждают чат от выдуманных цен. Там, где есть только опыт на собственной выборке, вывод остаётся локальным: повторите проверку на своих данных.
⚡
Главные статьи недели
01
Небольшой RAG-помощник начинается с проверки базы знаний
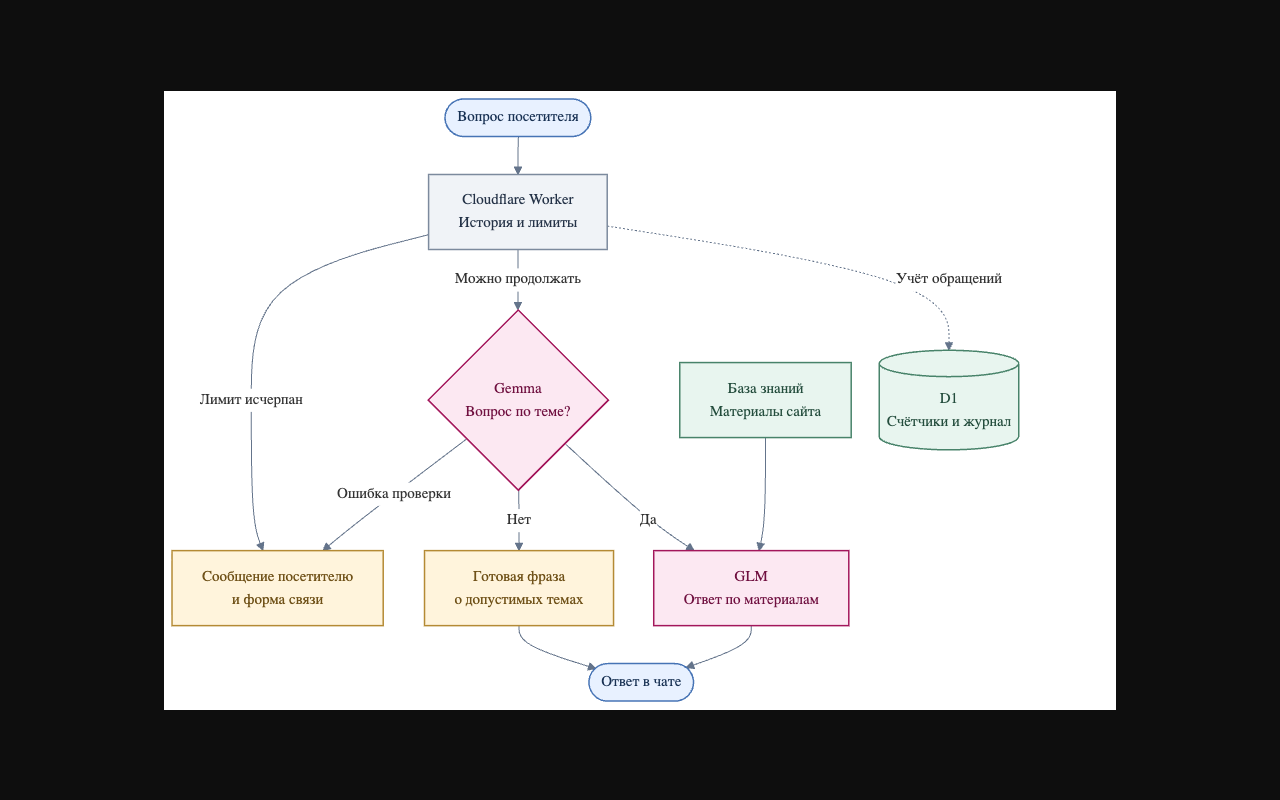
Статья разбирает помощника для сайта на Cloudflare Workers. Её самый переносимый приём — собрать базу только из опубликованных фактов и проверить вопросы, на которые сайт отвечать не должен.
🔑 Главное
Пока база короче 14 тысяч символов, помощник получает её целиком; затем выбирает шесть подходящих фрагментов.
Отдельная модель решает, относится ли вопрос к теме сайта, прежде чем запускать ответ.
Автор проверяет, чтобы проекты в разработке не становились готовыми кейсами, а отсутствующие цены не появлялись в базе.
⚡ Попробовать за вечер
Соберите короткую базу из публичных страниц своего проекта и сверьте каждый факт с исходником.
Подготовьте вопросы с отсутствующей ценой, несуществующим клиентом и задачей вне темы; проверьте отказ.
Метрика: число неподтверждённых утверждений и неверных отказов в контрольном наборе.
из статьи⌕
На картинке: Схема из статьи: Worker проверяет тему и лимиты, затем обращается к базе знаний и модели ответа.
Память проекта для Cursor: сначала файлы, затем индекс
✍ Иван ЕрёменкоХабр⏱ ≈24 минИскусственный интеллектМашинное обучение
О чём
В большом проекте автор хранит исходные сведения отдельно от wiki и обновляет локальный поиск QMD после проверки. Порядок шагов вынесен из инструкции агента в скрипт.
🔑 Главное
Материалы разделены на raw-источники и проверенную wiki.
Обёртка run-ingest.sh запускает обработку, validate-wiki.py и обновление индекса QMD.
Команды qmd update и qmd embed -c pharmacy-categories обновляют коллекцию; сравнение времени в статье — один контрольный замер.
⚡ Попробовать за вечер
Отделите исходные документы проекта от конспектов, которые пишет агент.
Вынесите порядок загрузки, проверки и переиндексации в один скрипт с остановкой на ошибке.
Метрика: ошибки проверки wiki и доля ответов, которые находят нужный исходный документ.
Автор поставил небольшую модель перед дорогой и размечал, какие запросы стоит пропускать дальше. Статья полезна как метод настройки фильтра, а не как обещание той же экономии.
🔑 Главное
На 67 размеченных материалах автор выбрал порог вероятности 0,2.
На его выборке фильтр сохранил хорошие материалы и отсёк 10 из 28 лишних.
При пустом ответе или ошибке фильтр пропускает материал дальше; пример кода требует правок.
⚡ Попробовать за вечер
Разметьте примеры нужных и лишних запросов по своим причинам отказа.
Выберите порог с запасом на пропуск полезного и неделю запускайте фильтр без влияния на выдачу.
Метрика: пропущенные полезные запросы, отсечённые лишние и цена проверки.
Автор использует Handy с локальным Whisper, а короткий Python-сервис передаёт распознанный текст модели для редактуры. Словарь и правила читаются заново для каждой диктовки.
🔑 Главное
Посредник слушает localhost:8765 и выглядит для Handy как обычный API.
В настройках Handy остаётся одна строка ${output}; остальные правила хранятся локально.
Автор проверял связку на Windows с Claude; работа маленьких локальных моделей им не проверена.
⚡ Попробовать за вечер
Настройте Handy с локальным Whisper и посредником из репозитория статьи.
Добавьте свои термины в словарь и продиктуйте фразу с паузами, самопоправкой и командой, которую нельзя исполнять.
Метрика: число неверных терминов и случаев, когда диктовка была принята за инструкцию.
✍ ZiverpupХабр⏱ ≈19 минПоисковые технологииМашинное обучение
О чём
Автор сравнил семантический поиск по заметкам Obsidian с дополнительным Rerank. Его метод полезен для проверки своего хранилища до автоматического включения второго этапа.
🔑 Главное
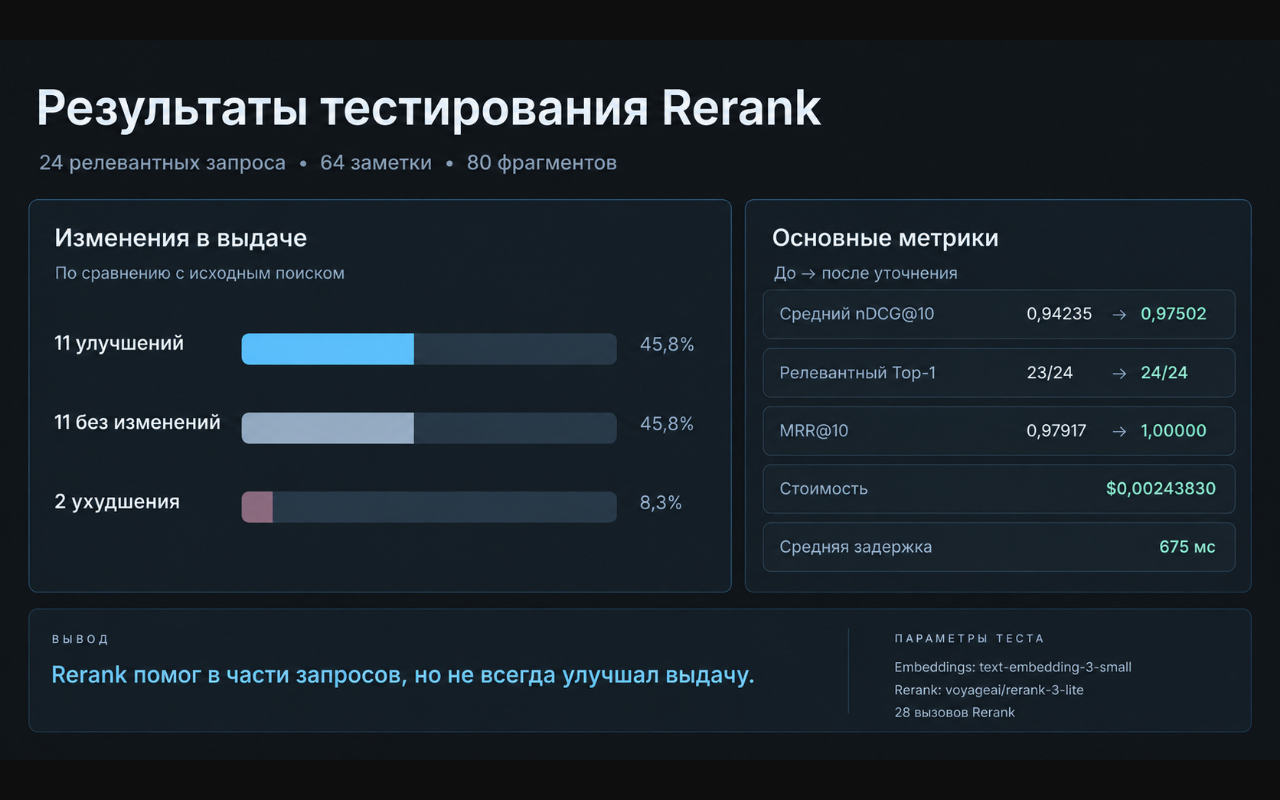
На 24 вопросах с существующим ответом Rerank улучшил nDCG@10 в 11 случаях, ухудшил в двух и не изменил ещё 11.
Базовый поиск уже ставил нужную заметку первой в 23 из 24 случаев.
Выборка из 64 заметок синтетическая; результат не переносится на другое хранилище без теста.
⚡ Попробовать за вечер
Разметьте 20–30 своих вопросов и оцените релевантность найденных заметок по шкале 0–3.
На одном и том же пуле кандидатов сравните порядок до и после Rerank.
Метрика: nDCG@10, Top-1, задержка и цена для одинаковых вопросов.
из статьи⌕
На картинке: Результат из статьи: 11 улучшений, 11 неизменных выдач и 2 ухудшения на 24 вопросах.
Автор проверила, как число и группировка инструментов MCP влияют на выбор действия в Claude Code, Codex CLI и других клиентах. Результат пригодится, когда вы проектируете собственный сервер инструментов.
🔑 Главное
Фейковый сервер содержал до 100 реалистично названных действий для файлов и документов.
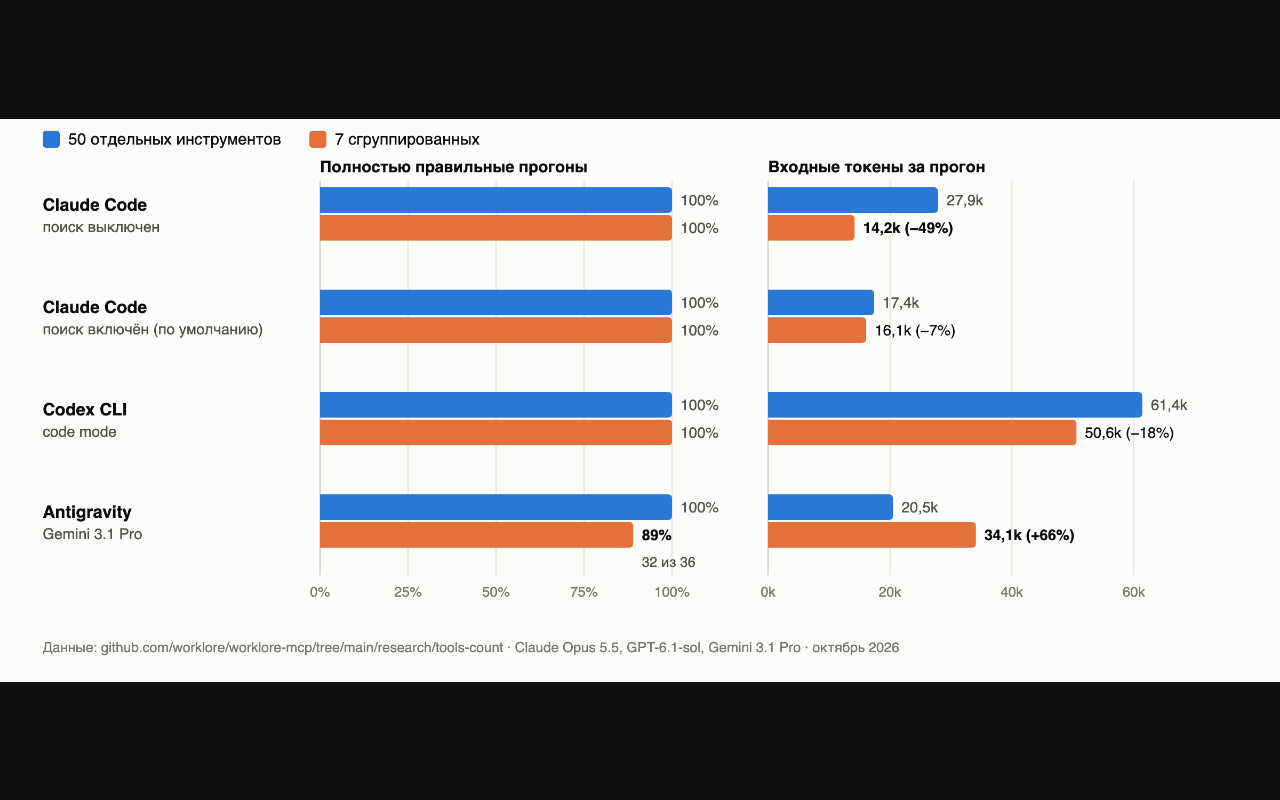
Группировка сократила входные токены в части клиентов, но в Antigravity снизила долю правильных прогонов.
Общие названия заставляли клиента искать по ключевым словам и читать больше схем; эксперимент охватывает одну предметную область.
⚡ Попробовать за вечер
Выпишите инструменты своего MCP-сервера и переименуйте общие глаголы по схеме «действие + объект».
Сравните обычную и сгруппированную схему в тех клиентах, которыми пользуются ваши читатели.
Метрика: доля верных вызовов и входные токены на одинаковых задачах.
из статьи⌕
На картинке: График исходного исследования: группировка снижает расход контекста не во всех клиентах и может менять точность.
Research First Builder показывает цепочку от поведения исходного проекта до решения под свои требования и проверки кодом. Это помогает разбирать спорные решения агента.
🔑 Главное
В evidence.json записаны источник, наблюдение, решение, шаг плана и проверка.
Пример с SQLite проверяет отклонение повторного URL через UNIQUE и IntegrityError.
Правильная структура отчёта не защищает от ложного вывода или поддельного результата теста.
⚡ Попробовать за вечер
Выберите одно спорное решение агента и попросите сначала указать строку кода или документации, на которую он опирается.
Запишите требование своего проекта, решение и маленький тест, который мог бы его опровергнуть.
Метрика: доля решений с проверяемым источником и проходящим тестом; отдельно проверьте вывод вручную.
 из статьи⌕